AI giọng nói cho nhân vật ảo là nhóm công nghệ biến văn bản hoặc giọng gốc thành lời nói tự nhiên cho avatar, NPC hay hướng dẫn viên ảo, gồm TTS (đọc văn bản), voice cloning (nhân bản giọng) và speech-to-speech (chuyển giọng, lồng tiếng). Trong XR, điểm khó không nằm ở việc “có giọng” mà ở độ trễ, cảm xúc, phát âm tiếng Việt chuẩn và quyền sử dụng giọng của người thật.
AI giọng nói cho nhân vật ảo là gì?
AI giọng nói cho nhân vật ảo là việc dùng mô hình học sâu để tạo ra lời nói cho một nhân vật trong game, ứng dụng VR/AR hoặc kênh tư vấn 3D, thay cho (hoặc bổ trợ) diễn viên lồng tiếng. Nhân vật có thể đọc kịch bản cố định, hoặc nói những câu được sinh ra tức thời bởi mô hình ngôn ngữ.
Trong kính VR, nghe hướng dẫn bằng lời dễ chịu hơn đọc chữ lơ lửng trước mắt, vì vậy giọng nói gần như là thành phần mặc định của digital human và trợ lý ảo trong không gian 3D.
Ba công nghệ cốt lõi: TTS, voice cloning và speech-to-speech
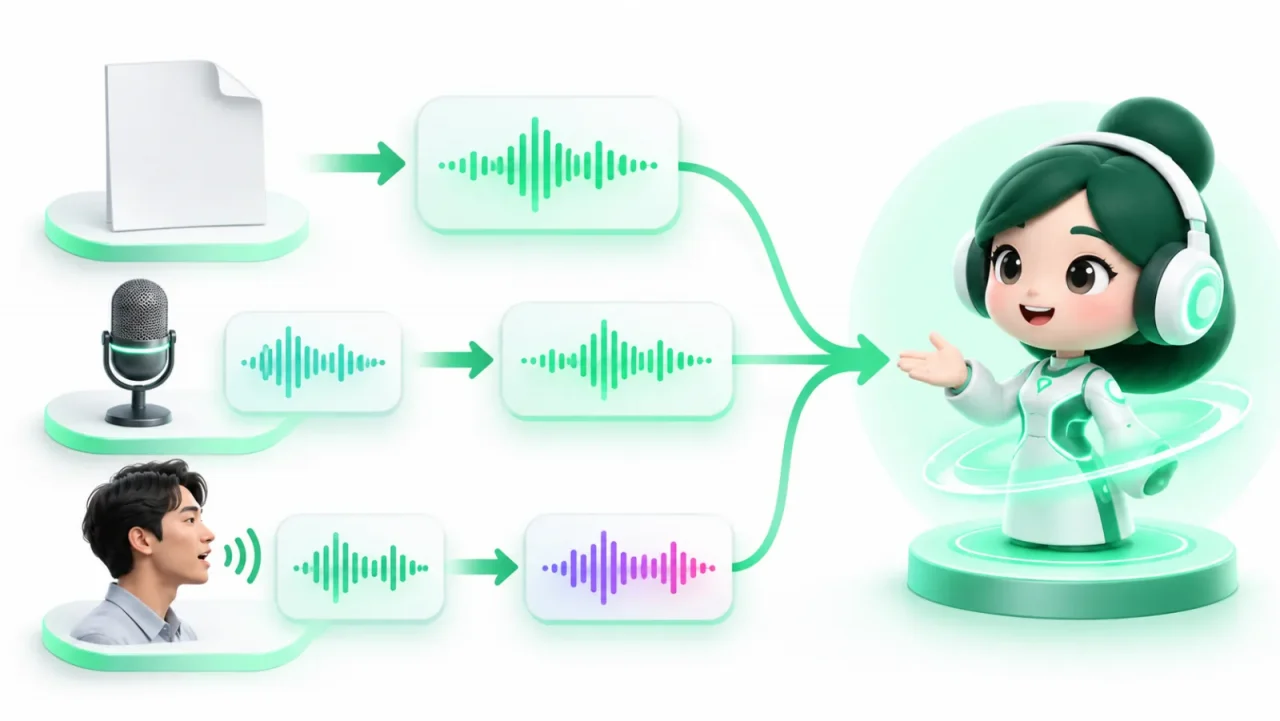
Có ba công nghệ chính tạo nên giọng nói cho nhân vật ảo, mỗi loại giải quyết một bài toán khác nhau.
Text-to-Speech (TTS)
TTS nhận văn bản và trả về âm thanh. Các hệ thống thế hệ mới dùng mạng nơ-ron để dự đoán ngữ điệu, trọng âm và nhịp nghỉ, nên nghe liền mạch hơn hẳn giọng “robot” ghép âm tiết của các thế hệ cũ.
Định nghĩa — Text-to-Speech (TTS): Công nghệ chuyển văn bản thành lời nói. TTS thần kinh (neural TTS) thường gồm một mô hình sinh biểu diễn âm học từ văn bản và một vocoder (bộ chuyển biểu diễn âm học thành sóng âm), hoặc gộp cả hai thành một mô hình đầu-cuối.
Với tiếng Việt, TTS phải xử lý sáu thanh điệu, cách đọc số, ngày tháng, từ viết tắt và từ mượn tiếng Anh.
Voice cloning (nhân bản giọng nói)
Voice cloning tạo ra một giọng mới mô phỏng âm sắc của một người cụ thể. Có hai cách phổ biến: zero-shot (chỉ cần một đoạn ghi âm ngắn làm mẫu tham chiếu) và tinh chỉnh (fine-tune mô hình trên vài chục phút đến vài giờ dữ liệu sạch).
Speech-to-Speech (chuyển giọng)
Speech-to-speech giữ nguyên nhịp điệu, cảm xúc và cách ngắt câu của một người nói, nhưng đổi âm sắc thành giọng nhân vật. Kỹ thuật này hữu ích khi cần diễn xuất có hồn: một diễn viên đọc thoại, AI chuyển thành giọng của nhiều nhân vật khác nhau.
Lồng tiếng đa ngôn ngữ cho trải nghiệm XR
Lồng tiếng đa ngôn ngữ bằng AI là chuỗi dịch kịch bản, tạo giọng ở ngôn ngữ đích và đồng bộ lại với hình ảnh, cho phép một trải nghiệm VR phục vụ khách quốc tế mà không phải sản xuất lại.
Một số hệ thống giữ được âm sắc giọng gốc khi chuyển ngôn ngữ (cross-lingual voice cloning), giúp thương hiệu nhất quán, nhưng chất lượng giữa các ngôn ngữ không đồng đều, cần người bản ngữ nghe duyệt.
Những điểm cần lưu ý khi lồng tiếng đa ngôn ngữ cho XR:
- Độ dài câu thay đổi:
bản dịch dài hoặc ngắn hơn bản gốc, dễ lệch thời điểm với hoạt cảnh. - Tên riêng và địa danh:
tên
di tích
, món ăn Việt Nam cần quy tắc phát âm riêng cho từng ngôn ngữ. - Khẩu hình:
khi đổi ngôn ngữ, chuyển động môi phải được tạo lại theo âm thanh mới, xem thêm bài
AI lip-sync và biểu cảm khuôn mặt
.
Với hội thoại trực tiếp giữa người với người qua kính AR, bài toán chuyển sang dịch thời gian thực, được phân tích riêng trong bài AI dịch thuật thời gian thực trong AR.
Chọn giải pháp giọng nói: so sánh nhanh
Không có lựa chọn tốt nhất cho mọi dự án; cách chọn phụ thuộc vào việc nhân vật nói kịch bản cố định hay hội thoại mở, chạy online hay offline, và yêu cầu bản quyền giọng.
| Tiêu chí | Diễn viên thu âm | TTS giọng có sẵn (API đám mây) | Voice cloning giọng riêng | Mô hình mã nguồn mở tự vận hành |
|---|---|---|---|---|
| Độ tự nhiên, cảm xúc | Cao nhất | Khá đến tốt | Tốt, phụ thuộc dữ liệu mẫu | Dao động lớn theo mô hình |
| Sửa nội dung | Chậm, tốn phí thu lại | Tức thì | Tức thì | Tức thì |
| Hội thoại thời gian thực | Không | Có (streaming) | Có, tùy nhà cung cấp | Có nếu đủ GPU |
| Chạy offline trên thiết bị | Có (file sẵn) | Thường không | Thường không | Có thể, với mô hình nhỏ |
| Rủi ro pháp lý giọng | Hợp đồng rõ ràng | Theo điều khoản nhà cung cấp | Cần đồng ý của chủ giọng | Kiểm tra giấy phép mô hình |
Chi phí tham khảo, tùy phạm vi dự án: TTS đám mây thường tính theo số ký tự; voice cloning có thêm phí thiết lập và thu âm mẫu; tự vận hành mô hình mở tốn chủ yếu ở GPU và nhân sự. Bảng giá thay đổi thường xuyên, nên đối chiếu báo giá mới nhất.
Quy trình xây giọng cho một nhân vật ảo
Một giọng nhân vật tốt bắt đầu từ tính cách nhân vật, không phải từ công cụ. Quy trình gợi ý gồm sáu bước:
- Định nghĩa “chân dung giọng”:
tuổi, giới, vùng miền, tốc độ nói, mức trang trọng, cảm xúc chủ đạo. Ví dụ: hướng dẫn viên bảo tàng giọng Bắc, trầm ấm, nói chậm vừa phải. - Chọn hướng kỹ thuật:
giọng có sẵn, voice cloning hay kết hợp diễn viên cho câu quan trọng và TTS cho phần động. - Thu âm mẫu (nếu clone):
phòng yên tĩnh, micro ổn định, kịch bản bao phủ đủ thanh điệu và loại câu; ký hợp đồng ghi rõ phạm vi sử dụng giọng. - Xây từ điển phát âm:
tên thương hiệu, sản phẩm, thuật ngữ, địa danh, đơn vị đo lường. - Tích hợp vào engine:
nối âm thanh với khẩu hình, đặt nguồn âm vào vị trí miệng nhân vật bằng
âm thanh không gian
. - Kiểm thử và giám sát:
nghe trong headset thật, đo độ trễ hội thoại; sau triển khai, ghi lại câu phát âm sai để cập nhật từ điển.
Góc kỹ thuật cho đội phát triển
Kiến trúc hội thoại thời gian thực
Một nhân vật biết nghe và đáp thường có chuỗi: VAD (phát hiện giọng nói) → ASR (nhận dạng giọng nói) → LLM (sinh câu trả lời) → TTS → phát âm thanh kèm khẩu hình. Tổng độ trễ là cộng dồn các khâu, vì vậy cần streaming ở mọi bước: LLM trả từng token, TTS nhận từng cụm câu và trả từng khung âm thanh. Cách xây NPC hội thoại đầy đủ được trình bày trong bài NPC thông minh dùng LLM.
Chia câu để giảm độ trễ
# Pseudo-code: đẩy từng cụm câu sang TTS ngay khi LLM sinh xong
buffer = ""
for token in llm.stream(prompt):
    buffer += token
    if ends_with_clause(buffer) and len(buffer) > 20:
        text = normalize_vi(buffer)        # số, ngày, viết tắt, từ điển riêng
        for chunk in tts.stream(text, voice="huong_dan_vien"):
            audio_queue.push(chunk)        # phát ngay, đồng thời sinh viseme
        buffer = ""
Kiểm soát phát âm và cảm xúc
- SSML
(ngôn ngữ đánh dấu tổng hợp tiếng nói) cho phép chèn nhịp nghỉ, chỉnh tốc độ, cao độ, đọc kiểu số; mức hỗ trợ khác nhau giữa các nhà cung cấp. - Một số mô hình nhận thẻ cảm xúc hoặc mô tả phong cách bằng ngôn ngữ tự nhiên; cần kiểm tra kỹ với tiếng Việt vì dữ liệu huấn luyện thường thiên về tiếng Anh.
Triển khai trên kính XR
Kính độc lập giới hạn về tính toán và nhiệt, nên phần lớn dự án gọi TTS qua đám mây. Nơi mạng không ổn định, hãy tạo sẵn thoại cố định thành file âm thanh hoặc dùng mô hình TTS nhỏ chạy cục bộ.
Ứng dụng thực tế tại Việt Nam
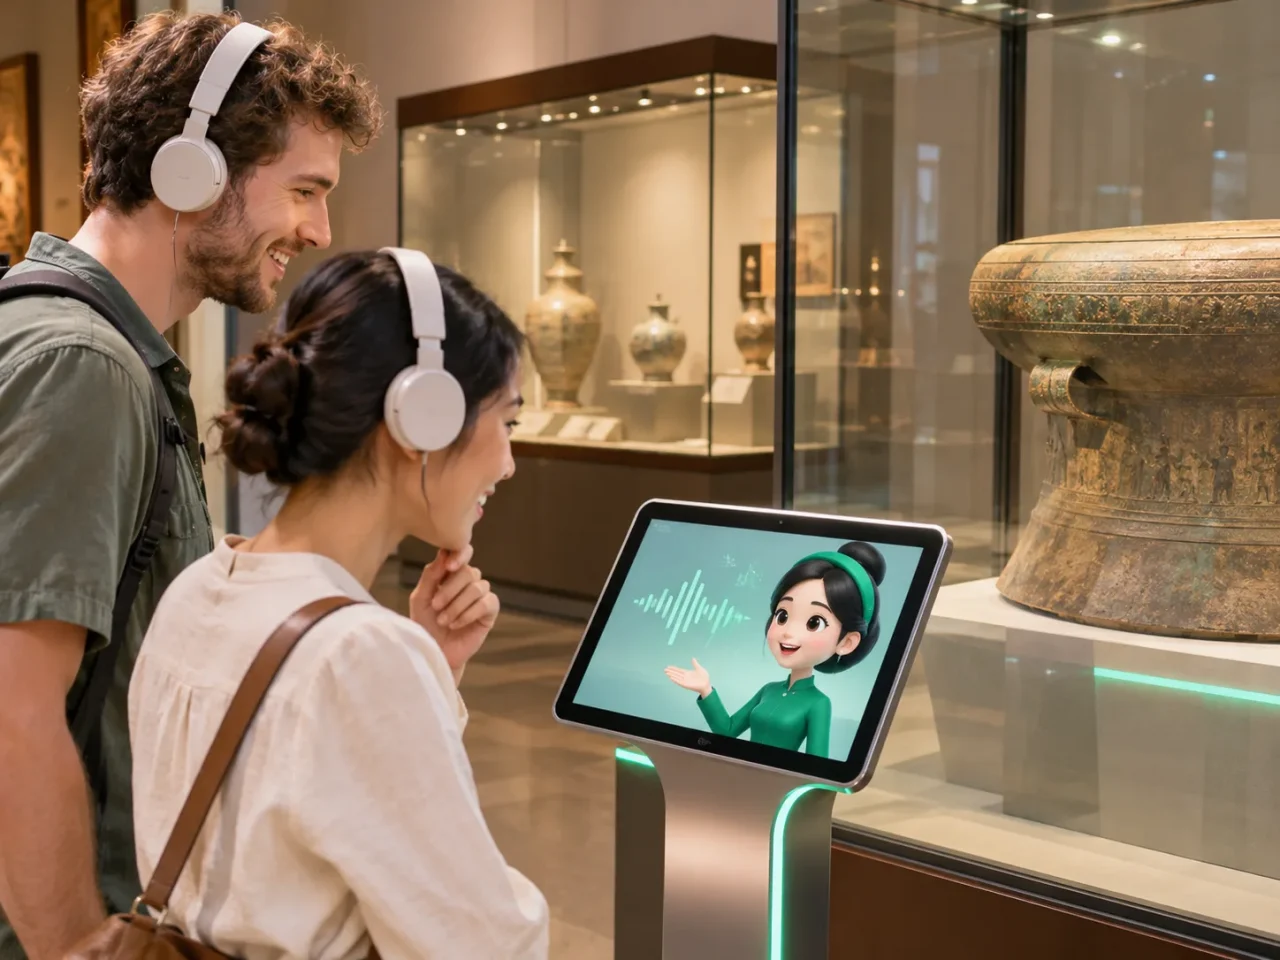
Tại Việt Nam, AI giọng nói đặc biệt hữu ích vì yêu cầu vùng miền và song ngữ xuất hiện trong nhiều dự án XR; thị trường đã có cả nhà cung cấp TTS tiếng Việt nội địa lẫn nền tảng quốc tế.
Kịch bản minh họa (giả định):
- Bảo tàng hoặc di tích:
hướng dẫn viên ảo nói tiếng Việt, tiếng Anh, tiếng Hàn với cùng âm sắc; nội dung thuyết minh được cập nhật khi có hiện vật mới mà không cần thu âm lại. - Đào tạo an toàn trong nhà máy:
nhân vật giám sát ảo nói giọng địa phương quen thuộc với công nhân, đọc quy trình bằng giọng chậm, rõ. - Bất động sản:
chuyên viên tư vấn ảo trong
nhà mẫu
VR trả lời câu hỏi về diện tích, tiến độ, đọc chuẩn tên dự án và số liệu.
Về pháp lý, giọng nói có thể được xem là dữ liệu cá nhân, thậm chí dữ liệu sinh trắc học, theo các quy định về bảo vệ dữ liệu cá nhân hiện hành như Nghị định 13/2023/NĐ-CP. Khi clone giọng nhân viên, người nổi tiếng hay diễn viên, cần văn bản đồng ý rõ phạm vi, thời hạn, kênh sử dụng và quyền rút lại. Doanh nghiệp nên tham vấn chuyên gia pháp lý, đồng thời tham khảo bài về đạo đức AI và deepfake để xây chính sách nội bộ.
Câu hỏi thường gặp (FAQ)
AI giọng nói tiếng Việt đã đủ tự nhiên để thay người lồng tiếng chưa?
Với nội dung hướng dẫn, thuyết minh, nhiều giọng TTS tiếng Việt đã đủ dùng. Với cảnh cần diễn xuất mạnh, diễn viên vẫn có lợi thế rõ rệt; cách làm phổ biến là kết hợp cả hai.
Có thể clone giọng của một người nổi tiếng cho nhân vật ảo không?
Về kỹ thuật là có thể, nhưng chỉ nên làm khi có sự đồng ý bằng văn bản của chủ giọng. Dùng giọng người khác khi chưa được phép có thể vi phạm quyền nhân thân, quy định dữ liệu cá nhân và gây khủng hoảng truyền thông.
Nhân vật hội thoại trong VR cần độ trễ bao nhiêu là chấp nhận được?
Không có con số chung cho mọi dự án; hãy đo từ lúc người dùng ngừng nói đến khi nghe âm thanh đầu tiên và tối ưu tới mức người thử không còn cảm thấy “chờ”.
TTS có chạy được offline trên kính VR không?
Có thể với mô hình nhỏ, nhưng chất lượng thường thấp hơn dịch vụ đám mây. Nếu nội dung cố định, đơn giản nhất là tạo sẵn file âm thanh và đóng gói vào ứng dụng.
Làm sao để giọng nhân vật đọc đúng tên thương hiệu và thuật ngữ?
Xây từ điển phát âm (lexicon) hoặc dùng SSML để chỉ định cách đọc. Bước chuẩn hóa văn bản trước khi gửi TTS cũng nên chuyển số, ngày, ký hiệu thành chữ theo quy tắc riêng của dự án.
Kết luận
AI giọng nói cho nhân vật ảo đã chuyển việc tạo thoại từ một khâu sản xuất tốn kém thành một lớp có thể chỉnh sửa, mở rộng ngôn ngữ và cá nhân hóa. Giá trị thật nằm ở cách kết hợp: TTS cho nội dung động, voice cloning cho bản sắc thương hiệu, diễn viên cho khoảnh khắc cần cảm xúc, cùng với khẩu hình, âm thanh không gian và quy trình đồng ý rõ ràng. Nếu bạn đang lên kế hoạch cho một nhân vật ảo biết nói trong dự án XR, hãy liên hệ đội ngũ tư vấn để được đánh giá nhu cầu và lựa chọn phương án giọng phù hợp.