AI lip-sync là kỹ thuật dùng mô hình học máy để tự động tạo chuyển động môi khớp với lời nói, và mở rộng ra cả biểu cảm khuôn mặt (mắt, lông mày, má) cho avatar 3D. Nhờ đó nhân vật trong VR/AR có thể “nói” bất kỳ câu nào, kể cả câu do AI sinh ra tức thời, mà không cần animator dựng tay từng khung hình.
AI lip-sync là gì?
AI lip-sync là việc dùng mô hình máy học để suy ra hình dạng miệng và khuôn mặt tại từng thời điểm dựa trên âm thanh lời nói hoặc hình ảnh người thật. Kết quả là chuỗi tham số điều khiển khuôn mặt avatar, chạy được trong Unity, Unreal hoặc trình duyệt.
Trước khi có AI, lip-sync thường làm theo hai cách: animator dựng tay theo từng câu thoại, hoặc dùng bảng tra cố định từ âm vị sang hình miệng. Cách đầu đẹp nhưng không mở rộng được; cách sau rẻ nhưng cứng, miệng “đóng mở” như búp bê. Khi nhân vật nói câu do AI giọng nói và LLM sinh ra tức thời, chỉ có phương pháp tự động mới theo kịp.
Định nghĩa — Viseme: Hình dạng miệng nhìn thấy được tương ứng với một nhóm âm vị (phoneme). Nhiều âm khác nhau khi nghe nhưng giống nhau khi nhìn, ví dụ “b”, “p”, “m” đều mím môi, nên được gộp chung một viseme.
Định nghĩa — Blendshape: Một biến thể hình học của lưới khuôn mặt (như “há miệng”, “nhếch mép trái”, “nhíu mày”). Trọng số 0–1 của mỗi blendshape được trộn lại để tạo biểu cảm tổng hợp.
Từ âm thanh đến chuyển động khuôn mặt
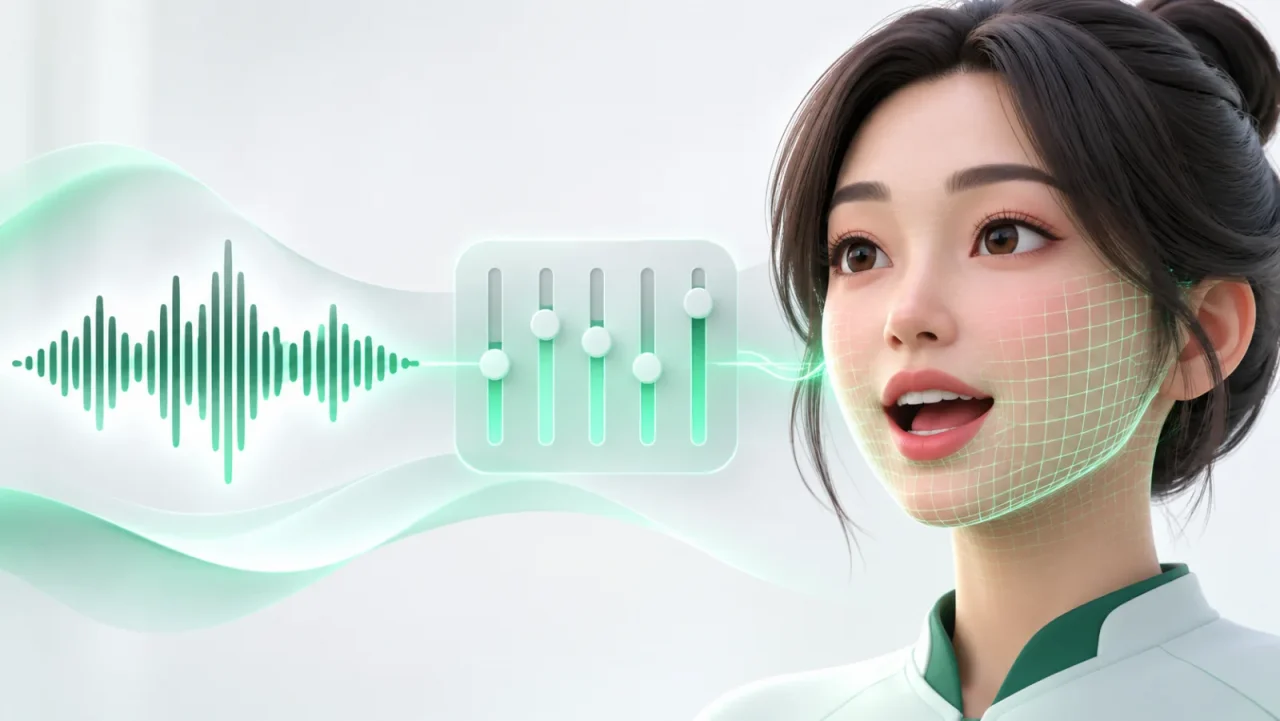
Một hệ thống lip-sync hiện đại nhận âm thanh, phân tích nội dung phát âm và cảm xúc, rồi xuất ra trọng số blendshape theo thời gian.
Audio-driven: điều khiển bằng âm thanh
Mô hình audio-to-face học từ dữ liệu ghép cặp giữa giọng nói và chuyển động mặt thật. Nó không chỉ dự đoán môi mà còn suy ra hàm, lưỡi, má, đôi khi cả lông mày theo nhấn nhá của câu. Ưu điểm lớn là không cần người diễn trước camera, phù hợp nhân vật hội thoại tự động.
Video-driven: điều khiển bằng khuôn mặt người thật
Face tracking dùng camera (webcam, điện thoại có cảm biến độ sâu hoặc camera trong headset) để đọc biểu cảm người thật và truyền sang avatar. Đây là cách các avatar xã hội trong VR thể hiện nụ cười, nháy mắt của người dùng. Với sản xuất nội dung, diễn viên có thể diễn trước điện thoại để tạo hoạt cảnh mặt cho nhân vật 3D.
Lớp biểu cảm phi ngôn ngữ
Khi không nói, nhân vật vẫn cần chớp mắt, đảo mắt nhẹ, thở, gật đầu khi lắng nghe. Nhiều dự án dùng một lớp “idle” sinh ngẫu nhiên có kiểm soát, cộng thêm quy tắc như nhìn về phía người dùng đang nói. Lớp này thường quan trọng không kém khẩu hình.
So sánh các phương pháp tạo biểu cảm
Lựa chọn phương pháp phụ thuộc vào việc nội dung là kịch bản cố định hay hội thoại mở, và mức chân thực mà avatar hướng tới.
| Phương pháp | Đầu vào | Chất lượng | Thời gian thực | Phù hợp |
|---|---|---|---|---|
| Dựng tay (keyframe) | Animator | Rất cao, có chủ đích | Không | Cảnh điện ảnh, trailer |
| Bảng tra viseme | Âm vị/văn bản | Cơ bản, hơi cứng | Có, rất nhẹ | Avatar cartoon, thiết bị yếu |
| Audio-to-face bằng AI | Âm thanh | Tốt, tự nhiên | Có, cần tài nguyên | Digital human, NPC hội thoại |
| Face capture từ diễn viên | Video/camera độ sâu | Cao, giàu cảm xúc | Có hoặc hậu kỳ | Nội dung kể chuyện, quảng cáo |
| Face tracking người dùng | Camera trong kính | Phụ thuộc thiết bị | Có | Avatar xã hội, họp ảo |
| Video lip-sync 2D | Video + âm thanh | Tốt trên video phẳng | Thường hậu kỳ | Video quảng cáo, không dùng cho 3D |
Mô hình lip-sync 2D chỉ chỉnh vùng miệng trên video, không tạo dữ liệu 3D cho avatar trong kính.
Vì sao khuôn mặt trong XR khó hơn trên màn hình?
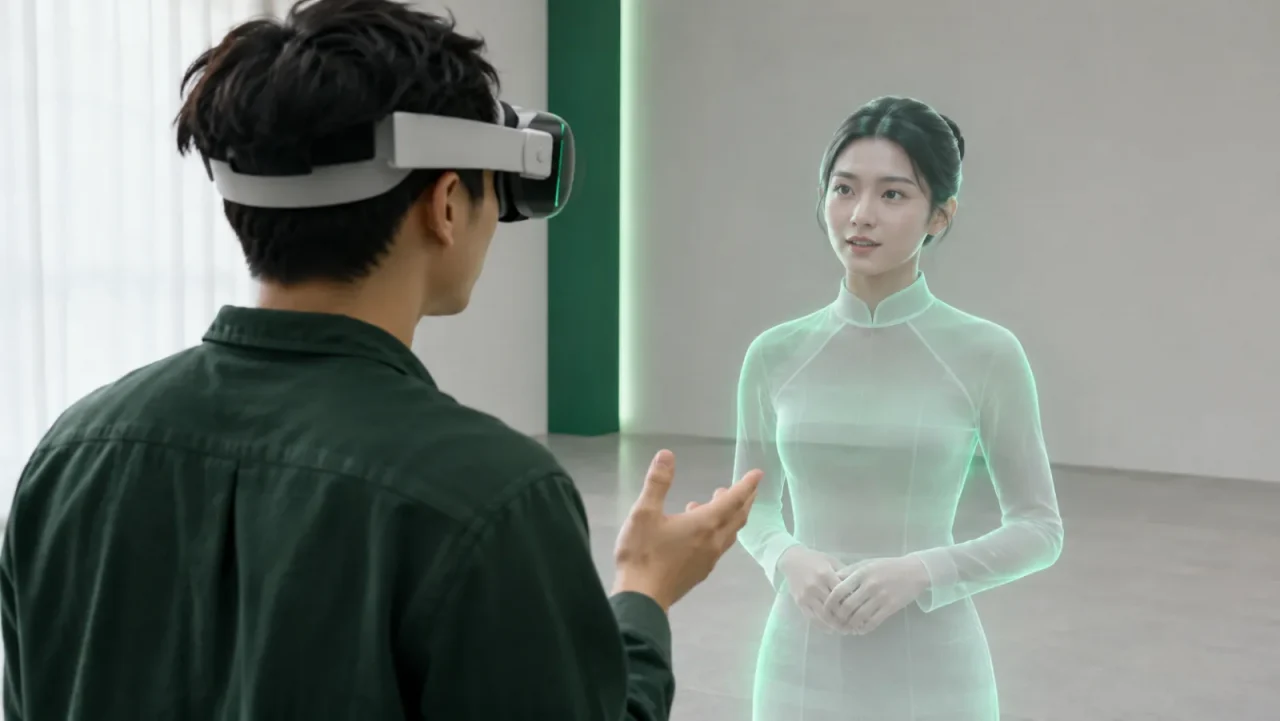
Khuôn mặt trong XR khó hơn vì người dùng nhìn nhân vật ở khoảng cách gần, kích thước thật, với chiều sâu lập thể, nên mọi sai lệch đều lộ rõ.
- Hiệu ứng thung lũng kỳ lạ (uncanny valley):
avatar càng giống người, người xem càng nhạy với lỗi nhỏ như môi trễ, mắt “chết”. - Đồng bộ thời gian:
trên màn hình, lệch tiếng và hình một chút có thể bỏ qua; trong VR khi đứng trước mặt nhân vật, độ lệch dễ bị phát hiện hơn. - Ngân sách hiệu năng:
kính độc lập phải dựng hai mắt ở tần số cao, nên số blendshape, độ phân giải texture da và shader tóc đều bị giới hạn. - Ánh mắt:
người dùng di chuyển tự do, nhân vật phải xoay mắt và đầu theo vị trí người dùng thay vì nhìn cố định vào camera.
Vì vậy, nhiều dự án XR chọn phong cách bán hiện thực (stylized) thay vì siêu thực, vừa nhẹ máy vừa tránh uncanny valley. Bài thiết kế brand avatar AI bàn sâu hơn về lựa chọn phong cách này.
Quy trình triển khai cho dự án
Quy trình gợi ý để đưa khuôn mặt biết nói vào một ứng dụng XR:
- Chọn phong cách và rig:
quyết định mức chân thực, chuẩn blendshape (ví dụ bộ hệ số kiểu ARKit) và kiểm tra rig có đủ biểu cảm. - Chọn nguồn điều khiển:
audio-driven cho hội thoại tự động, face capture cho cảnh kịch bản, face tracking cho avatar người dùng. - Xây lớp biểu cảm nền:
chớp mắt, thở, nhìn theo người dùng, phản ứng khi lắng nghe. - Tinh chỉnh theo ngôn ngữ:
chạy bộ câu kiểm thử tiếng Việt có đủ nguyên âm tròn môi, âm mím môi và câu nói nhanh. - Tối ưu cho thiết bị đích:
giảm blendshape không cần thiết, dùng LOD cho khuôn mặt khi nhân vật ở xa. - Kiểm thử trong kính:
quan sát ở khoảng cách hội thoại thật, ghi nhận phản hồi của người thử về độ “tự nhiên”.
Góc kỹ thuật cho đội phát triển
Luồng dữ liệu tham khảo
Với nhân vật hội thoại, luồng phổ biến: TTS trả âm thanh theo từng khối → mô hình audio-to-face (chạy trên server GPU hoặc cục bộ) xuất trọng số blendshape kèm timestamp → client đệm ngắn rồi phát đồng thời âm thanh và hoạt cảnh. Một số dịch vụ TTS trả sẵn sự kiện viseme kèm thời gian, đủ cho avatar đơn giản mà không cần mô hình riêng.
Hệ sinh thái công cụ đáng tìm hiểu: bộ blendshape khuôn mặt của ARKit (52 hệ số) được nhiều công cụ hỗ trợ; Epic MetaHuman và MetaHuman Animator cho Unreal Engine; các SDK chuyển động và khuôn mặt của nền tảng kính; công cụ audio-to-face trong hệ sinh thái NVIDIA. Tính năng và giấy phép thay đổi theo phiên bản, cần kiểm tra tài liệu mới nhất.
Làm mượt và đồng phát âm
Lời nói thật có hiện tượng đồng phát âm (coarticulation): miệng đã chuẩn bị cho âm sau khi đang phát âm trước. Nếu chuyển viseme đột ngột, môi sẽ giật. Pseudo-code làm mượt đơn giản:
# Trộn trọng số blendshape mỗi frame, có tăng/giảm khác nhau
for name, target in incoming_weights.items():
    current = weights[name]
    rate = attack if target > current else release   # mở nhanh, khép chậm
    weights[name] = current + (target - current) * min(1.0, rate * dt)
# Giữ âm mím môi (b, p, m) đủ khung để mắt người kịp nhận ra
enforce_min_hold(weights, ["mouthClose", "mouthPressLeft", "mouthPressRight"], frames=2)
Lưu ý với tiếng Việt
Thanh điệu tiếng Việt chủ yếu thể hiện qua cao độ, ít thay đổi hình môi, nhưng ảnh hưởng đến trường độ âm tiết và nhấn nhá, từ đó ảnh hưởng chuyển động hàm, lông mày và đầu. Các mô hình huấn luyện chủ yếu trên tiếng Anh có thể xử lý ổn phần môi nhưng thiếu nhịp điệu tự nhiên. Nên chuẩn bị bộ câu kiểm thử chuẩn và, nếu có ngân sách, ghi dữ liệu mặt người Việt để tinh chỉnh.
Tối ưu hiệu năng
Không phải blendshape nào cũng cần cập nhật mỗi frame. Có thể giảm tần số cập nhật khi nhân vật ở xa, tắt lớp biểu cảm phụ khi ngoài tầm nhìn. Tham khảo thêm bài tối ưu hiệu năng và 3D asset cho VR/AR.
Ứng dụng thực tế tại Việt Nam
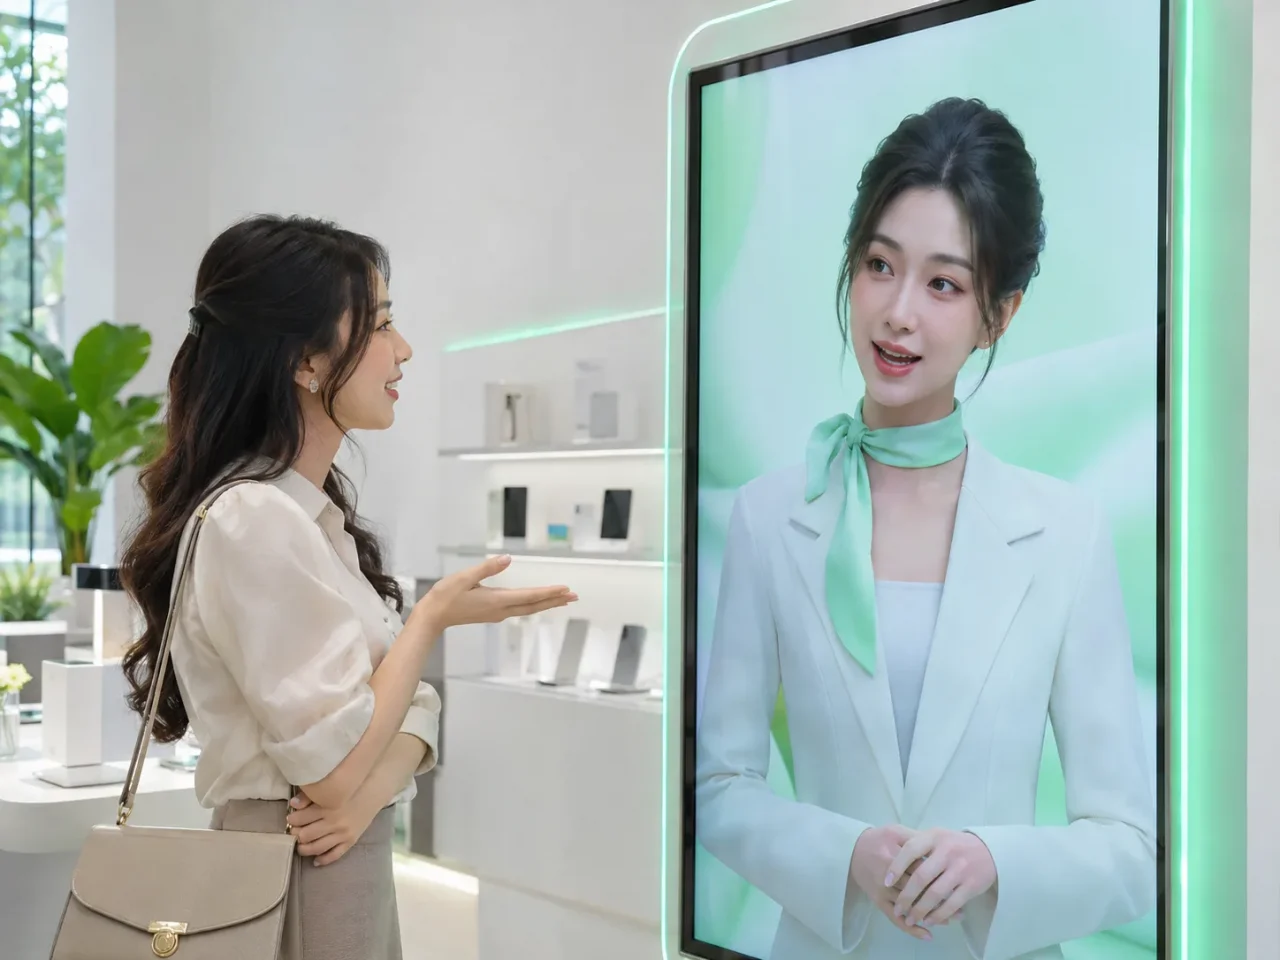
Nhu cầu khẩu hình tự động tại Việt Nam đang đến chủ yếu từ các dự án nhân vật số thương hiệu, đào tạo và giáo dục, nơi nội dung cần cập nhật thường xuyên.
Ví dụ minh họa (kịch bản giả định):
- Lễ tân ảo tại showroom:
avatar trên màn hình lớn hoặc trong kính VR trả lời khách, khẩu hình sinh từ âm thanh TTS tiếng Việt, có lớp nhìn theo khách khi họ di chuyển. - Bài giảng lịch sử trong VR:
nhân vật lịch sử được dựng 3D kể chuyện; nhóm sản xuất dùng diễn viên ghi mặt bằng điện thoại cho đoạn quan trọng, phần hỏi đáp dùng audio-driven. - Đào tạo kỹ năng giao tiếp:
khách hàng ảo phản ứng bằng nét mặt khó chịu hoặc hài lòng theo cách nhân viên ứng xử, giúp bài tập nhập vai thuyết phục hơn.
Với những dự án này, điểm nghẽn thường không nằm ở thuật toán mà ở rig khuôn mặt: avatar mua sẵn hoặc tạo tự động có thể thiếu blendshape, cần artist bổ sung. Khi xây digital human cho thương hiệu, nên kiểm tra rig từ sớm. Nếu khuôn mặt được dựng dựa trên người thật, cần sự đồng ý rõ ràng của người đó.
Câu hỏi thường gặp (FAQ)
AI lip-sync có cần diễn viên ghi hình không?
Không bắt buộc. Phương pháp audio-driven chỉ cần âm thanh lời nói để tạo khẩu hình và một phần biểu cảm.
Avatar nào cũng dùng được AI lip-sync?
Avatar phải có rig khuôn mặt với blendshape hoặc khung xương mặt phù hợp. Nhiều mô hình 3D tạo tự động hoặc tải từ thư viện chỉ có lưới tĩnh, cần bổ sung rig trước khi gắn lip-sync.
Lip-sync có chạy thời gian thực trên kính VR độc lập không?
Bảng tra viseme chạy rất nhẹ trên kính. Mô hình audio-to-face phức tạp hơn thường chạy trên server rồi gửi trọng số về, hoặc dùng phiên bản rút gọn.
Vì sao avatar nói đúng khẩu hình mà vẫn trông “giả”?
Thường do thiếu biểu cảm phi ngôn ngữ: mắt không chớp, không nhìn người đối diện, đầu bất động, hoặc chất liệu da và ánh sáng chưa tốt. Hãy bổ sung lớp idle và ánh mắt trước khi đầu tư thêm vào thuật toán khẩu hình.
Face tracking người dùng trong VR có ảnh hưởng quyền riêng tư không?
Có. Dữ liệu khuôn mặt và ánh mắt có thể tiết lộ cảm xúc và đặc điểm cá nhân. Ứng dụng nên xin phép rõ ràng, chỉ truyền trọng số biểu cảm thay vì hình ảnh thô, và tuân thủ chính sách của nền tảng cùng quy định dữ liệu cá nhân.
Kết luận
AI lip-sync giúp avatar 3D nói được mọi câu với khẩu hình và biểu cảm hợp lý, mở đường cho nhân vật hội thoại trong VR/AR ở quy mô lớn. Chất lượng cuối cùng phụ thuộc vào ba thứ: rig khuôn mặt tốt, nguồn điều khiển phù hợp và lớp biểu cảm phi ngôn ngữ được chăm chút, đặc biệt khi kiểm thử với tiếng Việt. Nếu bạn đang chuẩn bị đưa nhân vật biết nói vào dự án XR, hãy liên hệ đội ngũ tư vấn để được đánh giá nhu cầu và chọn phương án phù hợp ngân sách.