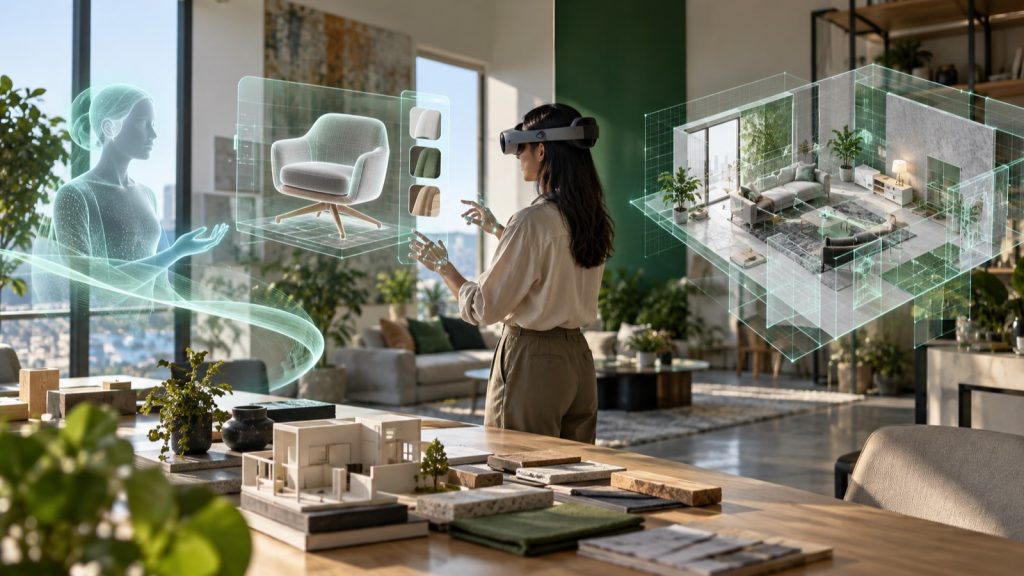
AI tạo mô hình 3D là nhóm công nghệ Generative AI biến một câu mô tả (Text-to-3D) hoặc một vài bức ảnh (Image-to-3D) thành mô hình 3D có hình khối và chất liệu chỉ trong vài giây đến vài phút. Công nghệ này đã đủ tốt để làm bản nháp, đạo cụ nền và mẫu thử cho dự án XR, nhưng vẫn cần nghệ sĩ 3D tinh chỉnh topology, UV và tối ưu trước khi đưa vào sản phẩm thật.
AI tạo mô hình 3D là gì?
AI tạo mô hình 3D là việc dùng mô hình học sâu để sinh ra vật thể ba chiều từ dữ liệu đầu vào đơn giản như văn bản, ảnh hoặc bản phác thảo. Thay vì nghệ sĩ dựng từng đỉnh, từng mặt trong Blender hay Maya, máy sẽ đề xuất một mô hình hoàn chỉnh để con người chọn lọc và chỉnh sửa.
Định nghĩa — Generative AI 3D: Nhánh của trí tuệ nhân tạo tạo sinh (Generative AI) chuyên sinh ra dữ liệu ba chiều như lưới đa giác (mesh), đám mây điểm (point cloud), trường thần kinh (neural field) hoặc Gaussian Splat, kèm theo chất liệu và màu sắc.
Điều này quan trọng vì nội dung 3D luôn là phần tốn kém nhất của dự án thực tế ảo: một cảnh VR có thể cần hàng trăm vật thể. AI không thay thế nghệ sĩ 3D mà đóng vai “trợ lý dựng nháp” rất nhanh. Xem bức tranh tổng quan trong bài AI trong thực tế ảo.
Text-to-3D và Image-to-3D khác nhau thế nào?
Khác biệt cốt lõi nằm ở đầu vào: Text-to-3D dựa vào mô tả bằng chữ nên sáng tạo tự do nhưng khó kiểm soát; Image-to-3D dựa vào hình ảnh nên bám sát vật thể cụ thể hơn.
Text-to-3D
Bạn gõ “chiếc ghế gỗ phong cách Đông Dương, lưng tựa đan mây” và hệ thống sinh ra mô hình tương ứng. Cách này hợp khi chưa có vật mẫu hoặc cần nhiều đạo cụ nền, nhưng mô tả bằng lời luôn mơ hồ nên tỷ lệ, kích thước thường không chính xác.
Image-to-3D
Bạn đưa vào một hoặc vài ảnh sản phẩm, AI suy luận phần bị che khuất để dựng mô hình hoàn chỉnh. Nhiều công cụ thực chất chạy chuỗi Text → Image → 3D, tận dụng các mô hình tạo ảnh vốn đã rất trưởng thành.
| Tiêu chí | Text-to-3D | Image-to-3D | Quét 3D (photogrammetry/splatting) |
|---|---|---|---|
| Đầu vào | Câu mô tả | 1 đến vài ảnh | Hàng chục đến hàng trăm ảnh/video |
| Độ bám vật thể thật | Thấp | Trung bình đến khá | Cao |
| Tốc độ | Vài giây đến vài phút | Vài giây đến vài phút | Vài phút đến vài giờ |
| Mặt khuất | AI tự “tưởng tượng” | AI tự suy luận | Được chụp thực tế |
| Phù hợp | Ý tưởng, đạo cụ nền | Sản phẩm, catalogue | Số hóa chính xác, di sản |
Nếu mục tiêu là số hóa chính xác một vật thể hay không gian có thật, các kỹ thuật quét vẫn vượt trội. Xem phân tích chi tiết trong bài so sánh NeRF, Photogrammetry và Gaussian Splatting.
Công nghệ đằng sau hoạt động ra sao?
Phần lớn hệ thống AI tạo mô hình 3D hiện nay kết hợp ba ý tưởng: mô hình khuếch tán (diffusion model) để “tưởng tượng” hình ảnh, sinh ảnh đa góc nhìn để có thông tin 3D, và mô hình tái tạo để ghép các góc nhìn thành vật thể.
Giai đoạn tối ưu hóa từng vật thể
Thế hệ đầu, tiêu biểu là DreamFusion của Google (2022), dùng Score Distillation Sampling (SDS — chưng cất điểm số từ mô hình khuếch tán 2D): render biểu diễn 3D từ nhiều góc và để mô hình ảnh 2D “chấm điểm”, chỉnh dần. Cách này chậm và hay gặp lỗi “Janus” (vật thể có nhiều mặt trước).
Giai đoạn đa góc nhìn và tái tạo nhanh
Sau đó, các mô hình sinh nhiều ảnh nhất quán theo góc nhìn, rồi dùng Large Reconstruction Model (LRM — mô hình tái tạo lớn dạng transformer) dựng 3D trong một lần suy luận. Đây là lý do nhiều công cụ trả kết quả trong vài giây.
Giai đoạn sinh 3D gốc
Xu hướng mới hơn là khuếch tán trực tiếp trong không gian 3D tiềm ẩn (latent 3D), sinh hình học trước rồi texture sau, cho hình khối sạch hơn. Các nền tảng thương mại như Meshy, Tripo, Rodin hay Luma đóng gói công nghệ thành dịch vụ web và API; tính năng và giá thay đổi liên tục, nên hãy kiểm tra thông tin mới nhất.
Quy trình đưa mô hình AI vào dự án XR
Mô hình AI chỉ có giá trị khi đi qua một quy trình kiểm soát chất lượng rõ ràng. Dưới đây là quy trình tham khảo mà nhiều studio áp dụng:
- Xác định vai trò vật thể:
vật thể chính (cầm, nhìn gần) nên dựng thủ công hoặc quét; đạo cụ nền có thể dùng AI. - Chuẩn bị đầu vào:
câu lệnh có cấu trúc (vật thể, chất liệu, phong cách) hoặc ảnh nền trơn, ánh sáng đều. - Sinh nhiều phương án:
tạo vài biến thể, chọn bản hình khối đúng nhất thay vì cố sửa bản kém. - Hậu kỳ hình học:
giảm đa giác (decimation), retopology (dựng lại lưới sạch), sửa lỗ hổng và mặt lật. - Làm lại UV và chất liệu:
tách UV gọn, chuyển texture sang bộ PBR (Physically Based Rendering — chất liệu dựa trên vật lý) gồm màu nền, độ nhám, kim loại, pháp tuyến. - Tối ưu cho thiết bị:
tạo các cấp độ chi tiết (LOD), nén texture, xuất glTF/GLB cho web và Android hoặc USDZ cho hệ sinh thái Apple. - Kiểm thử trong kính:
xem tỷ lệ thật, ánh sáng, hiệu năng khung hình trên thiết bị mục tiêu.
Phần tối ưu là bước hay bị bỏ qua nhất. Bạn có thể tham khảo thêm bài tối ưu hiệu năng và 3D asset cho VR/AR để nắm ngân sách đa giác và texture.
Góc kỹ thuật cho đội phát triển
Về kiến trúc, có thể hình dung một pipeline Image-to-3D hiện đại gồm bốn khối: bộ mã hóa ảnh (thường dựa trên ViT hoặc DINO), bộ sinh đa góc nhìn dựa trên diffusion, bộ tái tạo transformer xuất ra biểu diễn trung gian (triplane, voxel thưa hoặc Gaussian), và bước trích xuất lưới (Marching Cubes hoặc FlexiCubes) kèm nướng texture.
Những vấn đề kỹ thuật thường gặp
- Lưới dày, không đều:
đầu ra thường rất nhiều tam giác; với VR độc lập (standalone) cần decimation giữ đường viền hoặc retopology tự động (QuadRemesher, Instant Meshes). - Ánh sáng nướng vào màu:
texture chứa sẵn bóng đổ, trông “sai sáng” dưới ánh sáng động; cần tách albedo (de-lighting) hoặc chọn mô hình xuất PBR. - Tỷ lệ và pháp tuyến:
mô hình chuẩn hóa về hộp đơn vị nên phải scale theo kích thước thật; kiểm tra normal, xóa mặt không đa tạp (non-manifold).
Tự động hóa bằng script
Với thư viện lớn, nên chạy hậu kỳ hàng loạt. Pseudo-code minh họa:
for asset in generated_assets:
    mesh = load(asset.path)
    mesh = remove_non_manifold(mesh)
    mesh = decimate(mesh, target_tris=budget[asset.role])
    uv = auto_unwrap(mesh, margin=0.01)
    tex = rebake_pbr(asset.source_texture, uv, size=2048)
    lods = build_lods(mesh, ratios=[1.0, 0.5, 0.25])
    export_glb(mesh, tex, lods, draco=True, ktx2=True)
    validate(asset, max_tris=budget[asset.role], max_tex=2048)
Nén hình học bằng Draco/meshopt và texture bằng KTX2 giúp giảm dung lượng tải cho WebXR. Ở quy mô studio, nên gắn bước này vào pipeline AI cho studio XR. Nếu tự chạy mô hình mã nguồn mở, hãy kiểm tra yêu cầu VRAM và giấy phép (một số chỉ cho dùng phi thương mại).
Ứng dụng thực tế tại Việt Nam
Tại Việt Nam, công nghệ này hợp nhất với ngành cần nhiều vật thể nhưng ngân sách hạn chế. Các kịch bản dưới đây là giả định để minh họa.
Kịch bản minh họa 1 — Nội thất xuất khẩu: Một xưởng đồ gỗ tại Bình Dương có vài trăm mẫu bàn ghế chỉ có ảnh catalogue. Dùng Image-to-3D để dựng nhanh bản nháp, sau đó nghệ sĩ chỉnh các mẫu bán chạy nhất thành mô hình chất lượng cao cho showroom AR, còn mẫu ít phổ biến dùng bản tối ưu nhẹ.
Kịch bản minh họa 2 — Đào tạo VR: Một doanh nghiệp sản xuất cần môi trường nhà xưởng ảo với nhiều thùng, kệ, dụng cụ. Text-to-3D tạo đạo cụ nền, trong khi máy móc chính được dựng thủ công theo bản vẽ kỹ thuật để đảm bảo độ chính xác khi huấn luyện thao tác.
Tóm lại: AI lo “số lượng”, con người lo “chất lượng”.
Giới hạn, chi phí và rủi ro cần biết
AI tạo mô hình 3D giúp tiết kiệm thời gian ở giai đoạn đầu nhưng không miễn phí hoàn toàn về công sức. Chi phí thật nằm ở hậu kỳ, kiểm soát chất lượng và tích hợp.
| Hạng mục | Mức chi phí tham khảo (tùy phạm vi dự án) | Ghi chú |
|---|---|---|
| Gói dịch vụ AI 3D trực tuyến | Từ miễn phí giới hạn đến vài chục USD/tháng/người dùng | Kiểm tra quyền thương mại theo từng gói |
| Hậu kỳ một đạo cụ nền | Vài giờ công nghệ sĩ | Phụ thuộc độ phức tạp |
| Hậu kỳ một vật thể chính | Có thể gần bằng dựng mới | AI chủ yếu tiết kiệm phần ý tưởng |
| Tự vận hành mô hình mã nguồn mở | Chi phí GPU và nhân sự kỹ thuật | Phù hợp khi khối lượng lớn, dữ liệu nhạy cảm |
Về rủi ro, cần chú ý: quyền sở hữu và dùng thương mại đầu ra; ảnh sản phẩm chưa ra mắt có thể bị lưu trên máy chủ bên thứ ba; và kỳ vọng — mức tiết kiệm thực tế phụ thuộc nhiều vào yêu cầu chất lượng.
Câu hỏi thường gặp (FAQ)
AI tạo mô hình 3D có dùng trực tiếp cho kính VR được không?
Có thể dùng cho mục đích thử nghiệm, nhưng hiếm khi dùng ngay cho sản phẩm thương mại. Mô hình thô thường quá nặng, UV lộn xộn và texture chứa sẵn ánh sáng. Cần ít nhất bước giảm đa giác, làm lại chất liệu và kiểm tra hiệu năng trên thiết bị đích.
Text-to-3D hay Image-to-3D tốt hơn?
Không có lựa chọn tốt hơn tuyệt đối. Image-to-3D phù hợp khi bạn đã có vật thể hoặc ảnh sản phẩm cụ thể; Text-to-3D phù hợp khi đang ở giai đoạn ý tưởng hoặc cần nhiều đạo cụ nền đa dạng.
Mô hình do AI tạo ra có được bảo hộ bản quyền không?
Vấn đề này còn tranh luận ở nhiều quốc gia. Doanh nghiệp nên đọc kỹ điều khoản công cụ, lưu lại quy trình chỉnh sửa và tham khảo ý kiến pháp lý khi dùng cho sản phẩm quan trọng.
AI có thay thế được nghệ sĩ 3D không?
AI thay đổi công việc của nghệ sĩ 3D hơn là thay thế họ: phần dựng nháp được tự động hóa, còn thẩm mỹ, tối ưu và kiểm soát chất lượng trở nên quan trọng hơn.
Có nên tự triển khai mô hình mã nguồn mở thay vì dùng dịch vụ trực tuyến?
Nên cân nhắc khi khối lượng lớn, dữ liệu nhạy cảm hoặc cần tùy biến pipeline; với khối lượng nhỏ, dịch vụ trực tuyến thường tiết kiệm hơn.
Kết luận
AI tạo mô hình 3D, qua hai hướng Text-to-3D và Image-to-3D, đang rút ngắn đáng kể khoảng cách từ ý tưởng đến hình khối trong các dự án thực tế ảo. Giá trị lớn nhất nằm ở tốc độ thử nghiệm và nhân rộng thư viện đạo cụ, còn vật thể quan trọng vẫn cần con người hoàn thiện. Doanh nghiệp nên bắt đầu bằng một dự án thử nghiệm nhỏ, đo thời gian hậu kỳ thực tế rồi mới mở rộng. Nếu bạn đang cân nhắc đưa AI vào quy trình sản xuất nội dung 3D, hãy liên hệ đội ngũ tư vấn để được đánh giá nhu cầu và lộ trình phù hợp.