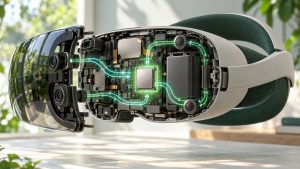
On-device AI là cách chạy mô hình AI ngay trên chip của kính XR thay vì gửi dữ liệu lên máy chủ. Cách này giúp phản hồi gần như tức thì, hoạt động khi mất mạng và giữ dữ liệu camera, giọng nói trong thiết bị. Đổi lại, mô hình phải được thu nhỏ và tối ưu rất kỹ vì kính bị giới hạn về điện năng, nhiệt và bộ nhớ.
On-device AI là gì?
On-device AI là việc chạy suy luận (inference — dùng mô hình đã huấn luyện để ra kết quả) ngay trên phần cứng của thiết bị. Với kính XR, hình ảnh camera, âm thanh và dữ liệu cảm biến được xử lý tại chỗ, không đi qua Internet.
Định nghĩa — On-device AI: Mô hình AI được nạp và chạy trên chip của thiết bị đầu cuối (điện thoại, kính, headset), thường tận dụng bộ xử lý chuyên cho AI gọi là NPU (Neural Processing Unit — đơn vị xử lý mạng nơ-ron). Huấn luyện mô hình vẫn diễn ra trên máy chủ; chỉ khâu suy luận được đưa xuống thiết bị.
Thực tế, mọi headset 6DoF hiện đại đã chạy nhiều mạng nơ-ron mỗi giây: theo dõi tay, định vị, nhận diện mặt phẳng (xem Computer Vision trong XR). Điểm mới của giai đoạn 2025–2026 là mô hình tạo sinh và đa phương thức bắt đầu có phiên bản đủ nhỏ cho thiết bị di động. Câu hỏi với đội sản phẩm vì thế chuyển thành “phần AI nào chạy ở đâu”.
Vì sao kính XR cần AI chạy trên thiết bị?
Kính XR cần on-device AI vì bốn lý do: độ trễ, quyền riêng tư, khả năng hoạt động ngoại tuyến và chi phí vận hành. Trong đó, độ trễ là yếu tố mang tính sống còn với trải nghiệm.
Độ trễ quyết định cảm giác “thật”
Trong VR, chuyển động đầu và hình ảnh phải khớp nhau trong vài chục mili giây, nếu không người dùng dễ chóng mặt. Theo dõi tay hay che khuất vật ảo bằng tay thật không thể chờ một vòng gửi lên máy chủ.
Dữ liệu, mạng và chi phí
Kính XR liên tục nhìn thấy khuôn mặt, màn hình, tài liệu nội bộ; xử lý cục bộ giảm lượng dữ liệu thô rời thiết bị (xem quyền riêng tư và bảo mật trong XR + AI). Nhà xưởng, hầm kỹ thuật hay vùng nông thôn thường sóng yếu, nên chức năng cốt lõi cần chạy được offline. Cuối cùng, chi phí gọi API cloud tăng theo số thiết bị, còn suy luận cục bộ giúp chi phí dễ dự đoán hơn.
Những giới hạn phần cứng phải chấp nhận
On-device AI trên kính bị giới hạn chủ yếu bởi điện năng, nhiệt, bộ nhớ và việc phải chia sẻ chip với tác vụ đồ họa. Hiểu rõ các ràng buộc này giúp đặt kỳ vọng đúng ngay từ đầu dự án.
| Ràng buộc | Headset VR/MR độc lập | Kính thông minh nhẹ | Ảnh hưởng tới AI |
|---|---|---|---|
| Điện năng | Pin lớn hơn, vài giờ sử dụng | Pin rất nhỏ, ưu tiên cả ngày | Mô hình nặng làm tụt thời lượng pin rõ rệt |
| Nhiệt | Có quạt hoặc tản nhiệt chủ động ở nhiều mẫu | Gần như không có tản nhiệt chủ động | Chip giảm xung khi nóng, tốc độ suy luận không ổn định |
| Bộ nhớ RAM | Vài GB đến hơn chục GB tùy dòng | Thấp hơn nhiều | Giới hạn kích thước mô hình nạp được |
| Tranh chấp tài nguyên | GPU bận render hai mắt ở tần số cao | Ít render nhưng chip yếu hơn | AI phải “nhường” cho hiển thị |
| Phần cứng AI | Thường có NPU/DSP chuyên dụng | Có NPU nhỏ hoặc đẩy sang điện thoại | Cần công cụ tối ưu riêng cho từng chip |
Thông số thay đổi theo từng thế hệ, hãy kiểm tra thông số mới nhất trước khi chốt kiến trúc (tham khảo hướng dẫn chọn kính VR/MR cho doanh nghiệp). Lưu ý: khi kính đã chạy định vị, render và passthrough, phần dư cho AI của bạn nhỏ hơn nhiều so với sức mạnh chip được quảng cáo.
Chia việc giữa kính, điện thoại và cloud
Kiến trúc hiệu quả nhất hiện nay là kiến trúc lai: tác vụ tức thì chạy trên kính, tác vụ trung bình trên điện thoại hoặc máy chủ biên, tác vụ nặng và không gấp lên cloud.
| Tầng xử lý | Ví dụ tác vụ phù hợp | Ưu điểm | Nhược điểm |
|---|---|---|---|
| Trên kính | Theo dõi tay/mắt, phát hiện từ đánh thức, nhận diện vật thể đơn giản, phân đoạn tay | Trễ thấp nhất, riêng tư, chạy offline | Mô hình nhỏ, hao pin |
| Điện thoại ghép đôi | Nhận dạng giọng nói, mô hình ngôn ngữ nhỏ, OCR | Chip mạnh hơn, pin lớn hơn | Phụ thuộc kết nối Bluetooth/Wi-Fi |
| Máy chủ biên (edge) | Mô hình thị giác vừa, xử lý nhiều kính trong một nhà máy | Dữ liệu ở trong mạng nội bộ | Cần đầu tư hạ tầng |
| Cloud | Mô hình ngôn ngữ lớn, tìm kiếm tri thức, tạo nội dung | Năng lực cao nhất | Trễ cao hơn, tốn chi phí, cần mạng |
Nếu dự án phụ thuộc mạnh vào hạ tầng mạng, bài Cloud XR, 5G và Edge Computing trình bày góc nhìn bổ sung từ phía máy chủ.
Quy trình chọn nơi chạy cho từng tác vụ có thể làm theo các bước sau:
- Liệt kê tác vụ AI
trong ứng dụng: nhận diện gì, hiểu gì, sinh ra gì. - Gán ngưỡng độ trễ
cho từng tác vụ: dưới 50 ms, dưới 500 ms, hay vài giây vẫn chấp nhận được. - Phân loại độ nhạy dữ liệu:
dữ liệu nào tuyệt đối không được rời thiết bị. - Kiểm tra điều kiện mạng
tại nơi sử dụng thật, không phải tại văn phòng. - Thử mô hình ứng viên
trên thiết bị mục tiêu, đo tốc độ, mức tiêu thụ pin và nhiệt sau 20–30 phút chạy liên tục. - Thiết kế cơ chế dự phòng:
khi mất mạng thì tác vụ cloud được thay bằng phiên bản cục bộ đơn giản hơn hoặc thông báo rõ cho người dùng.
Góc kỹ thuật cho đội phát triển
Đưa mô hình lên kính XR là bài toán tối ưu nhiều ràng buộc cùng lúc: kích thước, độ chính xác, độ trễ và năng lượng. Dưới đây là các kỹ thuật và công cụ phổ biến.
Kỹ thuật thu nhỏ mô hình
- Quantization (lượng tử hóa):
chuyển trọng số từ 32/16-bit xuống INT8 hoặc INT4. Lượng tử hóa sau huấn luyện (PTQ) nhanh gọn; huấn luyện có nhận biết lượng tử hóa (QAT) giữ độ chính xác tốt hơn. - Knowledge Distillation (chưng cất tri thức):
mô hình “học trò” nhỏ bắt chước mô hình “thầy” lớn. - Pruning (cắt tỉa):
loại bỏ trọng số hoặc kênh ít đóng góp. - Kiến trúc hiệu quả:
họ MobileNet, YOLO cỡ nhỏ, hoặc Small Language Model vài trăm triệu đến vài tỷ tham số.
Runtime và công cụ
Các lựa chọn phổ biến: LiteRT (tên mới của TensorFlow Lite), ONNX Runtime, Core ML trên hệ Apple, ExecuTorch của PyTorch và SDK của hãng chip như Qualcomm AI Engine. Unity có gói suy luận nơ-ron chính thức (trước đây tên Sentis) chạy mô hình ONNX trong engine. Hệ sinh thái đổi tên liên tục, hãy kiểm tra tài liệu mới nhất.
Mẫu tích hợp vào vòng lặp khung hình
Nguyên tắc quan trọng nhất: không bao giờ chặn luồng render để chờ AI. Pseudo-code tham khảo:
mỗi khung hình (72–120 Hz):
    render cảnh với kết quả AI gần nhất
    nếu (khung_hình % N == 0) và worker_AI rảnh:
        gửi ảnh camera đã thu nhỏ sang worker_AI (bất đồng bộ)

worker_AI (luồng riêng, NPU):
    kết_quả = model.infer(ảnh)
    làm_mượt(kết_quả, kết_quả_trước)   # lọc rung giữa các lần suy luận
    cập nhật kết_quả_gần_nhất (có khóa)
Tần suất suy luận không cần bằng tần số khung hình; nhận diện vài lần mỗi giây kết hợp theo dõi thường đủ cho nhiều ứng dụng AR.
Lưu ý khi đo đạc
- Đo ở trạng thái máy đã “nóng”, không chỉ vài lần chạy đầu.
- Theo dõi FPS: AI chiếm băng thông bộ nhớ có thể làm tụt khung hình dù chạy trên NPU.
- Kiểm tra độ chính xác sau lượng tử hóa trên dữ liệu thật, nhất là ánh sáng yếu.
Cách tối ưu tổng thể cho ứng dụng VR được bàn thêm trong bài tối ưu hiệu năng và 3D asset cho VR/AR.
Ứng dụng thực tế tại Việt Nam
On-device AI đặc biệt phù hợp với những môi trường làm việc tại Việt Nam có mạng không ổn định hoặc dữ liệu cần giữ kín. Các ví dụ dưới đây là kịch bản minh họa, không phải dự án cụ thể.
Nhà máy: Kỹ thuật viên đeo kính MR kiểm tra tủ điện; mô hình cục bộ nhận diện thiết bị và hiển thị bước kiểm tra ngay trong phòng kín sóng, chỉ báo cáo cuối ca được đồng bộ.
Đào tạo y khoa: Theo dõi tay chấm điểm thao tác, dữ liệu hình ảnh không rời thiết bị.
Du lịch và bảo tàng: Nhận diện hiện vật và phát thuyết minh ngay cả khi mạng nghẽn. Có thể kết hợp với AI dịch thuật thời gian thực trong AR cho du khách quốc tế.
Thách thức riêng là tiếng Việt: mô hình giọng nói và ngôn ngữ nhỏ chạy cục bộ thường kém bản cloud với giọng vùng miền, nên cần thử với người dùng thật trước khi quyết định.
Câu hỏi thường gặp (FAQ)
On-device AI có thay thế hoàn toàn AI trên cloud không?
Không. Mô hình mạnh nhất vẫn cần máy chủ. On-device AI phù hợp tác vụ cần nhanh, riêng tư hoặc offline; phần lớn sản phẩm dùng kết hợp cả hai.
Kính XR hiện nay có chạy được mô hình ngôn ngữ không?
Một số headset và điện thoại đi kèm đã chạy được mô hình ngôn ngữ nhỏ cho câu lệnh ngắn hay phân loại ý định. Khả năng thực tế phụ thuộc chip và RAM, cần thử trên thiết bị mục tiêu.
Chạy AI trên kính có làm nóng và hao pin không?
Có. Hãy giảm tần suất suy luận, ưu tiên NPU, lượng tử hóa mô hình và chỉ kích hoạt AI khi cần.
Dữ liệu xử lý trên thiết bị có hoàn toàn an toàn không?
An toàn hơn gửi dữ liệu thô lên mạng, nhưng không tuyệt đối: thiết bị có thể bị mất hoặc ứng dụng vẫn gửi kết quả ra ngoài. Cần kết hợp quản lý thiết bị, mã hóa và chính sách dữ liệu.
Doanh nghiệp nhỏ có nên đầu tư on-device AI ngay không?
Nên bắt đầu bằng PoC nhỏ với một tác vụ thực sự cần nhanh hoặc offline. Nếu mạng ổn định và dữ liệu không nhạy cảm, cloud có thể đơn giản hơn ở giai đoạn đầu.
Kết luận
On-device AI đang biến kính XR từ màn hình hiển thị thành thiết bị có khả năng tự hiểu môi trường và phản hồi tức thì. Giá trị cốt lõi nằm ở độ trễ thấp, quyền riêng tư và khả năng hoạt động khi mất mạng, nhưng đi kèm là bài toán tối ưu nghiêm ngặt về pin, nhiệt và bộ nhớ. Cách tiếp cận bền vững là kiến trúc lai, đặt đúng tác vụ ở đúng tầng xử lý và luôn đo đạc trên thiết bị thật. Để hiểu rộng hơn vai trò của AI trong hệ sinh thái này, bạn có thể xem bài khi AI gặp thực tế ảo. Nếu bạn đang cân nhắc đưa AI chạy trực tiếp trên kính cho một quy trình cụ thể, hãy liên hệ đội ngũ tư vấn để được đánh giá nhu cầu và phương án kỹ thuật phù hợp.