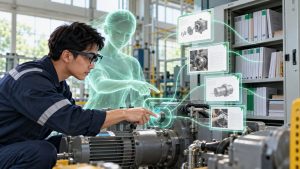
RAG trong XR là cách cho trợ lý AI trong kính VR/AR tra cứu tài liệu nội bộ (quy trình, sổ tay thiết bị, quy định an toàn) trước khi trả lời, nhờ đó câu trả lời bám sát nguồn và có trích dẫn. Đây là nền tảng để xây trợ lý đào tạo và trợ lý vận hành “rảnh tay”, nhưng chất lượng phụ thuộc lớn vào chất lượng tài liệu và cách kiểm soát câu trả lời.
RAG trong XR là gì?
RAG trong XR là việc kết hợp kỹ thuật truy xuất tài liệu với mô hình ngôn ngữ lớn (LLM) để tạo trợ lý AI trả lời theo tri thức riêng của doanh nghiệp, ngay trong trải nghiệm VR, AR hoặc MR. Người dùng hỏi bằng giọng nói, hệ thống tìm đoạn tài liệu phù hợp và LLM diễn đạt lại thành câu trả lời ngắn gọn.
Định nghĩa — RAG (Retrieval-Augmented Generation, sinh văn bản tăng cường bằng truy xuất): Kỹ thuật trong đó hệ thống tìm các đoạn thông tin liên quan từ kho tri thức, đưa vào ngữ cảnh của mô hình ngôn ngữ, rồi yêu cầu mô hình trả lời dựa trên các đoạn đó thay vì chỉ dựa vào kiến thức đã học.
So với LLM “trần” hay tinh chỉnh mô hình (fine-tuning), RAG gắn câu trả lời với tài liệu thật, chỉ ra được nguồn và cập nhật chỉ bằng cách thay tài liệu.
| Cách tiếp cận | Ưu điểm | Hạn chế | Phù hợp khi |
|---|---|---|---|
| LLM không có tri thức riêng | Triển khai nhanh | Không biết quy trình nội bộ, dễ trả lời sai | Hỏi đáp kiến thức chung |
| Fine-tuning | Học văn phong, định dạng riêng | Tốn kém, khó cập nhật, khó dẫn nguồn | Cần hành vi đặc thù ổn định |
| RAG | Bám tài liệu, có trích dẫn, cập nhật dễ | Phụ thuộc chất lượng tài liệu và truy xuất | Tri thức nội bộ, thay đổi thường xuyên |
| Kịch bản cố định | Kiểm soát tuyệt đối | Cứng nhắc, không xử lý câu hỏi ngoài kịch bản | Bài thi, quy trình bắt buộc từng chữ |
Nhiều hệ thống kết hợp: quy trình an toàn theo kịch bản cố định, hỏi đáp mở dùng RAG.
Vì sao XR cần trợ lý tri thức?
XR cần trợ lý tri thức vì người dùng trong kính thường bận tay, không thể mở tài liệu PDF hay gõ phím, trong khi các ngành dùng XR nhiều nhất (đào tạo kỹ thuật, bảo trì, an toàn) lại phụ thuộc vào tài liệu dày và chi tiết.
Trong một bài đào tạo bằng VR, học viên có thể hỏi “vì sao phải khóa van này trước?” và nhận câu trả lời ngay trong cảnh, kèm trích dẫn quy trình gốc. Trong AR, kỹ thuật viên hỏi thông số trong khi tay vẫn cầm dụng cụ.
XR còn bổ sung ngữ cảnh không gian mà chatbot thường không có: hệ thống biết người dùng đang ở bước 4, đang nhìn bơm số 2. Nhờ vậy câu hỏi mơ hồ như “cái này làm sao?” vẫn được truy xuất đúng.
Khác với NPC thông minh dùng LLM vốn tập trung vào tính cách và hội thoại tự nhiên, trợ lý RAG ưu tiên độ đúng và khả năng truy vết nguồn. Hai hướng có thể kết hợp: một nhân vật hướng dẫn có tính cách, nhưng kiến thức lấy từ kho tài liệu đã kiểm duyệt.
Các tình huống ứng dụng tiêu biểu
RAG trong XR phát huy giá trị rõ nhất ở những nơi tri thức nhiều, thay đổi, và sai sót có hậu quả.
| Tình huống | Nguồn tri thức | Giá trị mang lại | Lưu ý |
|---|---|---|---|
| Đào tạo vận hành trong VR | Quy trình chuẩn (SOP), sổ tay thiết bị | Học viên hỏi “vì sao” ngay khi thực hành | Cần đồng bộ phiên bản tài liệu với nội dung bài |
| Bảo trì bằng AR | Hướng dẫn sửa chữa, lịch sử sự cố | Tra cứu rảnh tay tại hiện trường | Môi trường ồn, cần nhận dạng giọng tốt |
| Hướng dẫn tham quan, bảo tàng | Tư liệu hiện vật, thuyết minh | Khách hỏi sâu theo sở thích | Kiểm duyệt nội dung lịch sử nhạy cảm |
| Onboarding nhân viên | Sổ tay nhân sự, quy định nội bộ | Giải đáp câu hỏi lặp lại | Phân quyền tài liệu theo vai trò |
| Bán hàng, nhà mẫu ảo | Thông số dự án, chính sách bán hàng | Trả lời nhất quán, đúng thông tin | Tránh để AI đưa cam kết pháp lý |
Với tình huống hiện trường, trợ lý RAG thường đi cùng giải pháp AR Remote Assist: AI xử lý câu hỏi thường gặp, chuyên gia từ xa chỉ được gọi khi AI không chắc chắn hoặc tình huống vượt khỏi tài liệu.
Quy trình triển khai trợ lý RAG cho XR
Triển khai hiệu quả bắt đầu từ tài liệu, không phải từ mô hình. Dưới đây là quy trình gợi ý.
- Chọn phạm vi hẹp:
Một dây chuyền, một dòng thiết bị hoặc một khóa đào tạo. Phạm vi hẹp giúp đánh giá chất lượng rõ ràng. - Kiểm kê và làm sạch tài liệu:
Loại bản cũ, gộp bản trùng, đánh dấu phiên bản và người chịu trách nhiệm. Tài liệu mâu thuẫn sẽ sinh câu trả lời mâu thuẫn. - Xây bộ câu hỏi đánh giá:
Thu 50–150 câu hỏi thật từ giảng viên, kỹ thuật viên, kèm đáp án chuẩn và nguồn. - Dựng pipeline và thử ngoài XR trước:
Kiểm tra chất lượng trên giao diện văn bản đơn giản, sửa truy xuất cho đến khi đạt ngưỡng chấp nhận. - Tích hợp vào trải nghiệm XR:
Thêm nhận dạng giọng nói, đọc câu trả lời, hiển thị trích dẫn và ngữ cảnh bước hiện tại. - Thử nghiệm với người dùng thật:
Đo tỷ lệ trả lời đúng, độ trễ, tỷ lệ chuyển sang người thật, mức hài lòng. - Thiết lập vòng cập nhật:
Ai duyệt tài liệu mới, bao lâu đánh giá lại, cách xử lý phản hồi “trả lời sai”.
Khâu 2 và 3 thường tốn công nhất nhưng hay bị đánh giá thấp.
Góc kỹ thuật cho đội phát triển
Về kiến trúc, trợ lý RAG trong XR là chuỗi xử lý giọng nói – truy xuất – sinh văn bản – giọng nói, cộng thêm luồng ngữ cảnh từ engine.
Pipeline tham khảo:
- Ingest:
Tách tài liệu (PDF, Word, wiki) thành đoạn (chunking) theo cấu trúc tiêu đề, giữ metadata: tên tài liệu, mục, phiên bản, thiết bị áp dụng, quyền truy cập. - Index:
Tạo embedding (vector biểu diễn nghĩa của văn bản) bằng mô hình hỗ trợ tốt tiếng Việt, lưu vào vector database; nên kết hợp thêm tìm kiếm từ khóa (hybrid search) vì mã thiết bị, số hiệu linh kiện thường khó khớp bằng vector. - Query:
Speech-to-Text chuyển giọng thành chữ; ghép câu hỏi với ngữ cảnh XR (bước hiện tại, đối tượng đang nhìn); truy xuất top-k đoạn, lọc theo metadata, xếp hạng lại bằng reranker. - Generate:
LLM trả lời ngắn, chỉ dựa trên đoạn được cung cấp, kèm mã nguồn trích dẫn; nếu không đủ thông tin thì nói rõ “không tìm thấy trong tài liệu”. - Output:
Text-to-Speech đọc câu trả lời, panel hiển thị trích dẫn và hình minh họa.
def answer(question_audio, xr_context):
    q = stt(question_audio)
    query = f"{q} | step: {xr_context.step} | object: {xr_context.gaze_target}"
    docs = hybrid_search(query, filters={"device": xr_context.device, "role": user.role})
    docs = rerank(q, docs)[:5]
    reply = llm(system=GROUNDED_PROMPT, context=docs, question=q, max_words=60)
    return tts(reply.text), reply.citations
Độ trễ: Dùng streaming cho LLM và TTS, phát âm báo ngay khi nhận câu hỏi, cache câu trả lời phổ biến.
Xử lý ở đâu: Kính độc lập khó chạy toàn bộ pipeline. Phương án phổ biến là STT/TTS nhẹ trên thiết bị hoặc cloud, truy xuất và LLM trên máy chủ. Với dữ liệu nhạy cảm, có thể triển khai mô hình trên máy chủ nội bộ. Bài on-device AI trên kính XR phân tích chi tiết các lựa chọn này.
Đánh giá: Đo riêng chất lượng truy xuất (đoạn đúng có nằm trong top-k không) và chất lượng câu trả lời (đúng, đủ, bám nguồn). Chạy lại bộ câu hỏi mỗi khi đổi mô hình, đổi cách chunking hoặc cập nhật tài liệu lớn.
Bối cảnh triển khai tại Việt Nam
Tại Việt Nam, RAG trong XR phù hợp với doanh nghiệp sản xuất, năng lượng, logistics và đào tạo nghề, nơi tài liệu kỹ thuật thường song ngữ Việt–Anh và nằm rải rác ở nhiều định dạng.
Thách thức ngôn ngữ: Tài liệu gốc từ nhà cung cấp thiết bị thường bằng tiếng Anh, trong khi người vận hành hỏi bằng tiếng Việt, đôi khi pha thuật ngữ địa phương. Cần chọn mô hình embedding và LLM xử lý tốt cả hai ngôn ngữ, đồng thời xây bảng thuật ngữ đồng nghĩa. Nhận dạng giọng nói cũng cần thử với nhiều giọng vùng miền và trong môi trường ồn của nhà xưởng.
Kịch bản giả định: Một nhà máy chế biến dựng mô phỏng VR vận hành dây chuyền mới, kèm trợ lý RAG lấy tri thức từ sổ tay nhà cung cấp và quy trình nội bộ đã Việt hóa. Giai đoạn đầu trợ lý chỉ trả lời câu hỏi “vì sao” và “ở đâu”; các bước an toàn bắt buộc vẫn theo kịch bản cố định. Câu trả lời bị đánh dấu sai được dùng để sửa tài liệu nguồn.
Dữ liệu và bảo mật: Tài liệu kỹ thuật, quy trình nội bộ có thể là bí mật kinh doanh. Cần quyết định rõ dữ liệu được xử lý ở đâu, ai được truy cập, và tham vấn chuyên gia về các quy định bảo vệ dữ liệu hiện hành. Nguyên tắc chung có trong bài quyền riêng tư và bảo mật trong XR + AI.
Chi phí gồm chuẩn bị tri thức, tích hợp XR và vận hành mô hình theo lượng sử dụng (tham khảo, tùy phạm vi dự án).
Câu hỏi thường gặp (FAQ)
RAG có loại bỏ hoàn toàn việc AI “bịa” thông tin không?
Không hoàn toàn. RAG giảm đáng kể rủi ro nhưng mô hình vẫn có thể diễn giải sai hoặc kết hợp sai các đoạn tài liệu. Cần prompt yêu cầu bám nguồn, hiển thị trích dẫn và cơ chế báo lỗi để người dùng kiểm chứng.
Cần bao nhiêu tài liệu để bắt đầu?
Không cần nhiều; cần đúng và sạch. Vài chục tài liệu cho một dòng thiết bị hay một khóa học là đủ để thử nghiệm.
Trợ lý RAG có chạy được trên kính không cần internet không?
Có thể với cấu hình rút gọn: mô hình nhỏ, kho tri thức hẹp, chạy trên thiết bị hoặc máy chủ trong mạng nội bộ. Cần kiểm tra trên thiết bị cụ thể trước khi cam kết.
Có nên để trợ lý AI hướng dẫn thao tác an toàn nguy hiểm không?
Với thao tác có rủi ro cao, nên dùng nội dung kịch bản đã kiểm duyệt làm kênh chính, còn trợ lý AI chỉ giải thích bổ sung. Quyết định cuối cùng vẫn theo quy trình và người phụ trách an toàn.
RAG khác gì chatbot trên website?
Kỹ thuật lõi có thể giống nhau; khác biệt nằm ở giọng nói rảnh tay, ngữ cảnh không gian và yêu cầu độ trễ thấp hơn.
Kết luận
RAG trong XR biến kính VR/AR thành nơi người học và người vận hành có thể hỏi đúng tài liệu của doanh nghiệp, đúng lúc đang thực hành, mà không phải rời tay khỏi công việc. Giá trị thật đến từ kho tri thức sạch, bộ câu hỏi đánh giá nghiêm túc và cách thiết kế để AI biết nói “tôi không chắc”. Hãy bắt đầu nhỏ, đo kỹ, rồi mở rộng. Nếu bạn đang có nội dung đào tạo hoặc tài liệu vận hành muốn đưa vào trợ lý XR, hãy liên hệ đội ngũ tư vấn để được đánh giá nhu cầu.