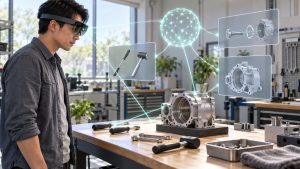
Vision-Language Model (VLM) là mô hình AI nhận đầu vào là hình ảnh hoặc video cùng văn bản, rồi trả lời, mô tả hay suy luận bằng ngôn ngữ tự nhiên. Trong XR, VLM đóng vai trò “bộ não thị giác” giúp kính và ứng dụng hiểu người dùng đang nhìn gì, từ đó hướng dẫn, kiểm tra thao tác, gắn nhãn nội dung 3D hay mô tả cảnh cho người khiếm thị, dù vẫn còn giới hạn về độ chính xác không gian và hiện tượng “bịa”.
Vision-Language Model là gì?
Vision-Language Model là loại mô hình AI có thể “nhìn” hình ảnh và “nói” về nó: bạn đưa một bức ảnh kèm câu hỏi, mô hình trả lời bằng văn bản. Ví dụ, chụp bảng điều khiển máy và hỏi “đèn báo nào đang sáng đỏ?”, VLM có thể chỉ ra và giải thích.
Định nghĩa — Vision-Language Model (VLM): Mô hình học sâu xử lý đồng thời dữ liệu thị giác (ảnh, video) và ngôn ngữ, có khả năng mô tả ảnh, trả lời câu hỏi về ảnh (visual question answering), đọc chữ trong ảnh và suy luận dựa trên những gì nhìn thấy.
Nhiều mô hình AI đa phương thức phổ biến hiện nay, cả thương mại lẫn mã nguồn mở, đều có năng lực VLM. Đây là nền tảng công nghệ đứng sau các trợ lý AI đa phương thức trên kính thông minh. Bài viết này đi sâu vào chính mô hình: nó hoạt động ra sao, làm được gì cho XR và giới hạn ở đâu.
VLM hoạt động như thế nào?
VLM hoạt động bằng cách biến hình ảnh thành chuỗi “token thị giác” mà mô hình ngôn ngữ có thể đọc giống như đọc chữ, rồi sinh câu trả lời dựa trên cả hai loại thông tin.
Kiến trúc phổ biến gồm ba phần:
- Bộ mã hóa hình ảnh (vision encoder):
chia ảnh thành các ô nhỏ, trích xuất đặc trưng thành vector. Bộ mã hóa thường được huấn luyện trước để gắn ảnh với mô tả văn bản. - Lớp kết nối (projector):
chuyển vector hình ảnh sang không gian biểu diễn của mô hình ngôn ngữ. - Mô hình ngôn ngữ lớn (LLM):
nhận cả token thị giác và câu hỏi, suy luận rồi sinh câu trả lời.
Mô hình được huấn luyện qua nhiều giai đoạn: học gắn kết ảnh–chữ trên dữ liệu lớn, sau đó tinh chỉnh bằng bộ hướng dẫn hỏi–đáp để biết làm theo yêu cầu. Với video, mô hình lấy mẫu một số khung hình và xử lý như chuỗi ảnh, nên các chi tiết xảy ra giữa hai khung lấy mẫu có thể bị bỏ sót.
Vai trò của VLM trong XR
VLM đóng vai trò lớp hiểu ngữ nghĩa cho XR: biến luồng camera và cảnh 3D thành thông tin có thể hỏi đáp, ra quyết định và hướng dẫn bằng ngôn ngữ tự nhiên.
Trợ lý theo ngữ cảnh
Người dùng nhìn vào một vật thể và hỏi “cái này dùng để làm gì?”, “bước tiếp theo là gì?”. VLM nhận khung hình từ camera kính, kết hợp với tài liệu nội bộ qua RAG để trả lời đúng quy trình của doanh nghiệp thay vì kiến thức chung trên mạng.
Kiểm tra thao tác và quy trình
Trong đào tạo hoặc bảo trì, VLM có thể đối chiếu hình ảnh với checklist: đã đeo găng tay chưa, van đã đóng chưa, dây đã cắm đúng cổng chưa. Kết quả nên được xem là gợi ý cần xác nhận, không phải phán quyết cuối.
Tăng tốc sản xuất nội dung 3D
Phía studio, VLM giúp tự động gắn nhãn, viết mô tả và từ khóa cho thư viện mô hình 3D, kiểm tra ảnh render có lỗi rõ ràng (texture sai, vật thể xuyên nhau), hoặc chấm điểm sơ bộ kết quả của các công cụ Generative AI tạo mô hình 3D.
Accessibility
VLM có thể mô tả cảnh xung quanh cho người khiếm thị, đọc biển báo, nhãn sản phẩm, hoặc tóm tắt nội dung một phòng trưng bày ảo bằng lời.
VLM so với computer vision truyền thống
VLM không thay thế hoàn toàn computer vision truyền thống; hai hướng bổ sung cho nhau.
| Tiêu chí | Computer vision truyền thống | Vision-Language Model |
|---|---|---|
| Đầu ra | Nhãn, khung bao, mặt nạ theo lớp định sẵn | Văn bản tự do, có thể kèm tọa độ |
| Thêm loại vật thể mới | Cần thu thập dữ liệu, huấn luyện lại | Thường chỉ cần mô tả bằng lời |
| Tốc độ | Rất nhanh, chạy tốt trên thiết bị | Chậm hơn, tốn tài nguyên hơn |
| Độ ổn định | Cao, dễ kiểm thử định lượng | Dao động theo cách hỏi, có thể “bịa” |
| Suy luận, giải thích | Hạn chế | Mạnh |
| Đo đạc, định vị chính xác | Tốt khi kết hợp cảm biến | Yếu, dễ sai về kích thước và khoảng cách |
Cách làm thực tế: dùng mô hình chuyên dụng nhẹ cho tác vụ lặp lại cần tốc độ (theo dõi tay, nhận diện marker, phân vùng), và gọi VLM khi cần hiểu ngữ cảnh mở. Phần cảm nhận hình học được bàn trong bài Spatial AI: máy hiểu không gian 3D như thế nào.
Giới hạn cần biết trước khi triển khai
VLM mạnh về hiểu ngữ nghĩa nhưng có những giới hạn mà doanh nghiệp cần tính trước:
- Hallucination (ảo giác):
mô hình có thể mô tả chi tiết không tồn tại, nhất là khi ảnh mờ hoặc câu hỏi dẫn dắt. - Suy luận không gian yếu:
đếm vật thể nhiều, ước lượng khoảng cách, phân biệt trái–phải theo góc nhìn vẫn là điểm yếu phổ biến. - Độ trễ và chi phí:
gửi ảnh độ phân giải cao lên đám mây liên tục tốn băng thông và tiền, không phù hợp vòng lặp thời gian thực. - Kiến thức chuyên ngành:
mô hình chung chưa chắc nhận ra thiết bị đặc thù của nhà máy bạn. - Quyền riêng tư:
camera kính có thể thu cả khuôn mặt, màn hình, tài liệu mật của người khác.
Góc kỹ thuật cho đội phát triển
Kiến trúc lai thiết bị – đám mây
Mẫu kiến trúc phổ biến cho kính XR: trên thiết bị chạy SLAM, theo dõi tay và các bộ phát hiện nhẹ liên tục; chỉ khi có sự kiện (người dùng hỏi, vật thể quan trọng xuất hiện, chuyển bước quy trình) mới cắt khung hình gửi VLM. Xu hướng on-device AI với VLM cỡ nhỏ giúp xử lý một số câu hỏi cục bộ, giảm độ trễ và lộ dữ liệu.
Quy trình đưa VLM vào ứng dụng
- Xác định tác vụ cụ thể và tiêu chí đúng/sai đo được.
- Thu thập bộ ảnh kiểm thử từ chính góc nhìn của kính (egocentric), có ánh sáng và độ mờ thật.
- So sánh vài mô hình, ghi lại độ chính xác, độ trễ, chi phí mỗi yêu cầu.
- Thiết kế prompt có cấu trúc, yêu cầu đầu ra JSON để ứng dụng xử lý được.
- Thêm lớp kiểm chứng: ngưỡng tin cậy, hỏi lại người dùng, hoặc đối chiếu cảm biến.
- Triển khai thử, theo dõi log, bổ sung ví dụ khó vào bộ kiểm thử.
Ép đầu ra có cấu trúc
# Pseudo-code: kiểm tra một bước quy trình bằng VLM
frame = camera.capture(crop=gaze_region, max_side=1024)
prompt = ("Bước hiện tại: 'Đóng van V-12 trước khi tháo nắp'. "
          "Quan sát ảnh và trả về JSON: "
          '{"van_dong": true|false|null, "do_tin_cay": 0-1, "ly_do": "..."} '
          "Trả null nếu không nhìn rõ van.")
result = vlm.generate(image=frame, text=prompt, response_format="json")
if result.van_dong is None or result.do_tin_cay < 0.7:
    ui.ask_user("Hãy nhìn gần vào van V-12 để xác nhận.")
Cho phép trả lời “không chắc” (null) giúp giảm việc mô hình đoán bừa.
Tối ưu hình ảnh đầu vào
Cắt vùng quanh điểm nhìn hoặc vùng tay đang thao tác thay vì gửi toàn khung hình; ghép thêm thông tin từ cảnh 3D (tên đối tượng đã neo, khoảng cách đo bằng cảm biến) vào prompt dạng văn bản để bù cho điểm yếu không gian của VLM.
Ứng dụng thực tế tại Việt Nam
Tại Việt Nam, VLM mở ra cơ hội cho các ứng dụng XR cần hiểu tiếng Việt và bối cảnh địa phương: biển hiệu, tài liệu, quy trình nội bộ.
Ví dụ minh họa (kịch bản giả định):
- Bảo trì thiết bị:
kỹ thuật viên đeo kính hỏi “đèn cảnh báo này nghĩa là gì?”, VLM đọc mã lỗi trên màn hình máy, tra tài liệu nội bộ và hiển thị các bước xử lý; khi cần, cuộc gọi chuyển sang chuyên gia qua
AR Remote Assist
. - Bán lẻ:
nhân viên mới
chụp kệ hàng, VLM kiểm tra vị trí trưng bày theo sơ đồ chuẩn và gợi ý điều chỉnh. - Studio XR:
tự động viết mô tả tiếng Việt và tiếng Anh cho hàng nghìn mô hình 3D trong thư viện, giúp tìm kiếm nội bộ dễ hơn. - Bảo tàng:
khách hướng camera vào hiện vật, ứng dụng nhận ra hiện vật và mở phần thuyết minh tương ứng.
Cần đánh giá kỹ khả năng đọc chữ tiếng Việt có dấu, chữ viết tay và ảnh chụp trong điều kiện ánh sáng kém, vì đây là nơi mô hình thường sai. Với hình ảnh từ nhà xưởng, văn phòng, cần quy định rõ dữ liệu nào được gửi ra ngoài và tham vấn chuyên gia về quy định dữ liệu cá nhân.
Câu hỏi thường gặp (FAQ)
VLM khác gì với LLM?
LLM chỉ xử lý văn bản. VLM bổ sung khả năng nhận hình ảnh hoặc video làm đầu vào, nhờ một bộ mã hóa thị giác gắn với mô hình ngôn ngữ. Nhiều mô hình đa phương thức hiện nay vừa là LLM vừa có năng lực VLM.
VLM có chạy trực tiếp trên kính XR không?
Một số VLM cỡ nhỏ có thể chạy trên thiết bị di động mạnh, nhưng chất lượng thường thấp hơn mô hình lớn trên đám mây. Phổ biến hơn là kiến trúc lai: thiết bị xử lý tác vụ nhẹ, đám mây xử lý câu hỏi phức tạp. Cần kiểm tra trên thiết bị mục tiêu cụ thể.
VLM có đọc được chữ tiếng Việt trong ảnh không?
Nhiều mô hình đọc được chữ in tiếng Việt khá tốt, nhưng dễ sai dấu với ảnh nhỏ, nghiêng, chữ viết tay hoặc phông đặc biệt. Nếu tác vụ phụ thuộc vào chữ, nên kết hợp OCR chuyên dụng và kiểm thử với dữ liệu thật.
Làm sao hạn chế VLM trả lời sai?
Cho phép mô hình trả lời “không chắc”, yêu cầu đầu ra có cấu trúc, cung cấp ngữ cảnh từ tài liệu doanh nghiệp, và thêm bước xác nhận của người dùng cho các quyết định quan trọng.
Doanh nghiệp nhỏ có nên dùng VLM trong dự án XR?
Có, nếu bắt đầu từ một tác vụ rõ ràng như gắn nhãn thư viện 3D hay trả lời câu hỏi về sản phẩm. Dùng API sẵn có giúp thử nghiệm nhanh mà không cần đội nghiên cứu riêng; chi phí tính theo lượng sử dụng, cần ước tính trước theo kịch bản thực tế.
Kết luận
Vision-Language Model là mảnh ghép giúp XR chuyển từ “nhìn thấy” sang “hiểu và giải thích” thế giới, mở ra trợ lý theo ngữ cảnh, kiểm tra quy trình và tự động hóa sản xuất nội dung. Hiểu đúng VLM là gì, điểm mạnh và giới hạn của nó, đặc biệt về suy luận không gian và hiện tượng bịa, sẽ giúp doanh nghiệp thiết kế giải pháp lai an toàn và hiệu quả. Nếu bạn muốn đánh giá khả năng áp dụng VLM vào ứng dụng XR của mình, hãy liên hệ đội ngũ tư vấn để được đánh giá nhu cầu và lộ trình thử nghiệm phù hợp.